A conta que muda: Nemotron 3.5 ativa 3B de 30B de parâmetros e o custo por token que barateia suas automações
O post do NVIDIA Technical Blog sobre o Nemotron 3.5 Lightning traz um número que deveria reescrever o cálculo de ROI de qualquer operação de marketing que depende de IA em volume: o modelo tem 30 bilhões de parâmetros, mas ativa apenas 3 bilhões por token. Isso não é uma curiosidade de engenharia — é a diferença entre uma automação que só se paga em escala e uma que se paga quase imediatamente.
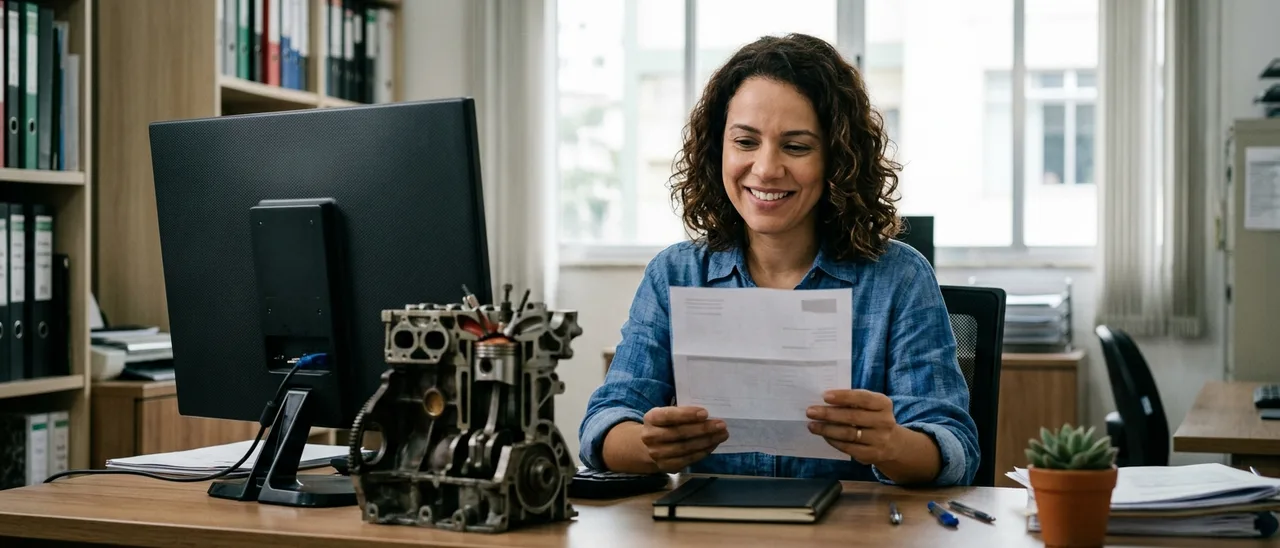
A arquitetura por trás disso se chama Mixture-of-Experts (MoE), e o texto da NVIDIA explica a mecânica com uma analogia útil: imagine dois motores com o mesmo deslocamento total; um dispara todos os cilindros a cada ciclo, o outro ativa apenas os cilindros que precisa naquele momento. No caso do Nemotron, o modelo armazena 30B de parâmetros mas, para cada token processado, um “roteador” interno decide quais especialistas (módulos especializados) precisam entrar em ação. Os demais ficam em espera, consumindo memória, mas não poder de processamento.
Para quem usa IA para operar campanhas, criar conteúdo em escala ou rodar agentes de venda, o desdobramento prático é imediato e se resume a uma palavra: custo.
O que a arquitetura MoE muda no seu custo de operação
Modelos densos — como o Gemma 4 31B, citado na comparação do artigo — ativam todos os parâmetros para cada token. Isso quer dizer que, a cada nova palavra gerada, a infraestrutura inteira trabalha. É como pagar por um estúdio completo de produção para cada frase de um roteiro. A vantagem? Simplicidade. A desvantagem? Conta alta.
O MoE quebra essa lógica. Conforme o artigo técnico da NVIDIA destaca, a arquitetura “desacopla memória de computação”: o custo de armazenar o modelo existe sempre (memória VRAM é paga antecipadamente), mas o custo de processamento é pago por token, e só pelos especialistas efetivamente usados. Na prática: você mantém a capacidade de um modelo grande, mas o custo variável de cada chamada se aproxima do de um modelo pequeno.
O que isso significa para o seu dia a dia operacional?
-
Automações de alto volume viram viáveis. Se a sua operação processa milhares de tokens por dia alimentando classificações de leads, respostas automáticas ou variações de anúncio, o custo marginal de cada chamada despenca. O que antes era proibitivo em escala, agora tem uma matemática que fecha.
-
O preço de API tende a cair no médio prazo. O texto da NVIDIA aponta que o Nemotron 3.5 Lightning roda a US$ 0,22 por milhão de tokens de saída — um décimo quarto do preço do Qwen3.8-27B, que cobra US$ 3,00 e entrega velocidade muito menor na comparação direta. Quando modelos de qualidade competitiva chegam ao mercado com esse preço, o patamar geral de preço de APIs de IA é puxado para baixo.
-
O benchmark concreto: na comparação de velocidade de saída feita pelo Artificial Analysis e citada pela NVIDIA, o Nemotron 3.5 Lightning entrega entre 235,7 e 494,2 tokens por segundo contra 36,9 a 222,4 do Gemma 4 31B. Em operações que pagam por hora de processamento, essa diferença é decisiva.
O ponto central é que a discussão deixa de ser “qual modelo tem mais parâmetros?” e passa a ser “quanto custa cada token que eu preciso para fazer o meu trabalho?”.
Nem todo caso é para MoE: onde o modelo denso ainda vence
Para não cairmos na armadilha de tratar o MoE como solução universal, o artigo da NVIDIA é honesto sobre os tradeoffs. A escolha entre denso e MoE depende do seu contexto de deployment, e há três fatores que merecem atenção:
Memória e capacidade de resposta. Um modelo MoE de 30B exige aproximadamente a mesma VRAM de um denso de 30B — são cerca de 60 GB para ambos. A diferença está no que você obtém com esses gigabytes: o denso converte memória em capacidade bruta de raciocínio; o MoE converte memória em throughput (quantidade de tokens por segundo). Se o seu caso envolve uma única chamada complexa que decide o rumo de uma campanha (definir a estratégia de uma landing page, por exemplo), o denso pode ser a escolha mais previsível.
Concorrência alta e latência. Para uma única requisição, o MoE ganha claramente. Ainda segundo a análise da NVIDIA, a vantagem de throughput se mantém conforme a concorrência sobe, mas a margem de latência se comprime. Em um cenário de muitas requisições simultâneas com exigência de resposta rápida, o roteamento e a movimentação de memória cobram seu preço. A orientação técnica é: faça benchmark antes de decidir.
Você pretende fazer fine-tuning? Esse é um ponto que a maioria dos posts sobre arquitetura de modelos ignora, mas que afeta diretamente quem quer ajustar um modelo aos dados da própria empresa. O artigo da NVIDIA é claro: um fine-tuning completo em um modelo MoE pode desbalancear o roteador, fazendo com que alguns especialistas fiquem superutilizados e outros sejam “esquecidos”. A recomendação para quem quer ajustar é usar abordagens LoRA/PEFT ou congelar o roteador — e, no caso específico do Nemotron, a NVIDIA oferece receitas de fine-tuning via NeMo que lidam corretamente com essa questão. No lado denso, o fine-tuning é mais simples porque todos os parâmetros são atualizados de forma uniforme.
Há ainda a questão da quantização (compactação do modelo para rodar em menos memória). O artigo aponta que, em MoE, a camada do roteador é sensível a perturbações mínimas — pequenas mudanças podem mudar decisões de roteamento. Em modelos híbridos como o Qwen3.8-27B, as projeções recorrentes também são críticas. O ponto prático: se você precisa rodar o modelo em GPUs menores, a compactação precisa ser feita com cuidado, não é um simples “comprimir tudo pela metade”.
A decisão que importa para o seu negócio
O texto da NVIDIA posiciona o Nemotron 3.5 Lightning como um modelo aberto (weights, dados e receitas à disposição no Hugging Face e no ModelScope), o que abre portas para deploy local e completa independência de APIs de terceiros — um fator relevante se você trabalha com dados sensíveis de clientes.
Mas a contribuição mais valiosa do artigo é o quadro de decisão que ele monta. Não é sobre parâmetros, é sobre a natureza da sua tarefa. O MoE é descrito como adequado para uma “camada de execução de agentes” — tarefas bem especificadas, repetidas em volume, em que a consistência e o custo baixo importam mais do que um raciocínio profundo. O modelo denso continua sendo a escolha quando um único raciocínio de alto nível decide o desfecho.
Isso reorienta a forma como você avalia ferramentas de IA no mercado. Deixe de lado a pergunta “qual modelo tem mais parâmetros?” e faça três perguntas objetivas:
- Qual é o volume de chamadas que a minha automação faz por dia? Volume alto + tarefas repetitivas = MoE tende a ser mais econômico.
- A latência é crítica? Se cada milissegundo importa em uma jornada de compra em tempo real, benchmarks com concorrência alta são indispensáveis.
- Eu preciso de fine-tuning no modelo? Se sim, o custo de engenharia para fazer isso bem em MoE pode comer a economia de inferência.
A arquitetura MoE não é uma novidade absoluta, mas a chegada de modelos como o Nemotron 3.5 Lightning com esse nível de qualidade, peso aberto e preço competitivo (US$ 0,22 por milhão de tokens de saída contra US$ 0,40 do Gemma 4 31B, segundo a comparação da NVIDIA) é o tipo de movimento que redefine o patamar de custo da indústria. Para o profissional de marketing que opera automações com IA, a mensagem é direta: o custo por token caiu de patamar, e quem não reavaliar suas escolhas de infraestrutura vai acabar pagando mais caro por um resultado que tem alternativa mais barata — e, em alguns casos, mais rápida — disponível hoje.